
H200 (Nvidia)
GPU NVIDIA H200 — fiche produit officielle NVIDIA.
Génération : Hopper (même architecture que le H100).
Cette architecture a été annoncée le 13 novembre 2023 au SC23, et a été commercialisée à partir du deuxième trimestre 2024.
Journaux liées à cette note :
Héberger des open weights chez Scaleway et OVH : modèles, serveurs et coûts
Après avoir publié ma note "Qu'est-ce que je dois faire signer à mes clients pour être autorisé à analyser leurs données confidentielles avec un LLM ?" je souhaite maintenant identifier les modèles Open Weights que je peux héberger sur les offres GPU Instances de Scaleway et Cloud GPU d'OVH, et à quel coût.
Note : dans ce document, tous les tarifs sont exprimés hors taxes et ont été relevés le 11 septembre 2026.
Version courte
Pour les lecteurs pressés, voici la version courte :
- MiniMax M2.5 hébergé sur 4x H100 coûte de 7 770 € à 9 322 €/mois en continu, ou de 806 € à 919 €/mois pour 72 h.
- DeepSeek-V4-Flash-Vision-Exp hébergé sur 4x ou 8x H200 ou 8x B300, coûte de 16 877 € à 43 800 €/mois en continu, ou de 1 664 € à 4 320 €/mois pour 72 h.
- Ces environnements peuvent confortablement servir environ 32 utilisateurs simultanés, soit environ 200 utilisateurs actifs.
Comment j'ai fait ma sélection de modèle à analyser ?
Pour faire ma sélection de modèle, je me suis basé sur Browse all vLLM recipes et les cookbooks de SGLang, j'ai parcouru toutes les listes et j'ai sélectionné deux modèles aux profils complémentaires : un petit modèle, léger à héberger et que je trouve utile malgré ses limites, et un modèle plus puissant.
Je suis arrivé à la sélection suivante :
- Pour le modèle peu puissant, j'ai sélectionné MiniMax M2.5, dont les capacités se situent entre Claude Sonnet 4.5 (sorti en septembre 2025) et Sonnet 4.6 (sorti en février 2026)
- DeepSeek-V4-Flash-Vision-Exp avec le support de la vision. Cela correspond à mon modèle préféré du moment, pour cela voir ma note Septembre 2026 - je code avec des open weights pour 10 à 30 € par mois
Et voici les serveurs requis pour les faire tourner, indiqués dans leurs recettes vLLM :
- 4x H100 pour MiniMax M2.5 (recette vLLM)
- 4x H200 ou 8x B300 pour DeepSeek-V4-Flash-Vision-Exp (recette vLLM)
Les offres GPU de Scaleway et OVH retenues
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | H100-SXM-2-80G | 6,62 € | 4 832 € |
| Scaleway | H100-SXM-4-80G | 12,77 € | 9 322 € |
| Scaleway | H100-SXM-8-80G | 25,33 € | 18 491 € |
| Scaleway | B300-SXM-8-288G | 60 € | 43 800 € |
| OVH | 4x H100 PCIe (80 Go HBM2e) | 11,2 € | 7 770 € |
| OVH | 4x H200 (141 Go HBM3e) | 23,12 € | 16 877 € |
| OVH | 8x H200 (141 Go HBM3e) | 42 € | 30 660 € |
Pages :
- https://www.scaleway.com/fr/tarifs/gpu/?zone=fr-par-2
- https://www.ovhcloud.com/fr/public-cloud/prices/#cloud-gpu
Offres pour faire tourner DeepSeek-V4-Flash-Vision-Exp ?
Tout d'abord, j'ai observé que DeepSeek-V4-Flash-Vision-Exp (~168 Go, recette vLLM) a pratiquement la même taille que DeepSeek-V4-Flash-0731 (~167 Go, checkpoint fused, recette vLLM), l'écart est de moins de 1 Go pour intégrer les couches vision. Par conséquent, je suppose qu'un serveur qui permet de faire tourner la version DeepSeek-V4-Flash peut faire tourner la version DeepSeek-V4-Flash-Vision-Exp.
J'apporte ici ces précisions car la recette vLLM de DeepSeek-V4-Flash contient plus de hardware validé que celle de vLLM de DeepSeek-V4-Flash-Vision-Exp, qui ne valide un run vision que sur 4xGB200. Le cookbook SGLang documente de son côté un run vérifié sur 4xB200. Toujours dans le cookbook SGLang, l'installation sur 4xH200 est annoncée comme pending, même si des essais communautaires sur cette config existent déjà (avec un bug connu sur les tool calls multi-tours).
D'après mon analyse à l'aide de Sonnet 5 des pages recettes vLLM, des issues GitHub vLLM et d'autres articles trouvés plus largement sur Internet, il est probable que DeepSeek-V4-Flash-Vision-Exp peut charger sur les offres suivantes :
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | B300-SXM-8-288G | 60 € | 43 800 € |
| OVH | 4x H200 | 23,12 € | 16 877 € |
| OVH | 8x H200 | 42 € | 30 660 € |
Attention : la recette annonce une context window de 1M de tokens, mais elle est explicite sur ce point — cette valeur est annoncée, non mesurée (le run de référence tourne en 32K) et le KV cache d'un contexte 1M réclame bien plus de mémoire que les poids (~202 Go de VRAM avant KV cache). Ces offres garantissent donc le chargement du modèle, pas le service de 1M de tokens ; le contexte réellement tenable reste à mesurer.
J'ai effectué des recherches pour savoir si le modèle pouvait tourner sur 8x H100. D'après les retours, il peut démarrer mais reste instable et bridé en contexte sur cette génération :
| Source | Config | Contexte testé | Statut |
|---|---|---|---|
| #52065 | 8x H100 80G, TP8+EP, fp8 KV, util 0.90 | 65 536 (64K) | Fonctionne sur vLLM 0.26.0, crash sur 0.27.0 avec DSpark |
| #51326 | 8x H100 80G, TP8+EP, util 0.84 | Non précisé | Sortie corrompue sur 0.26.0, correcte sur 0.25.0 |
La variante Vision-Exp stocke ses experts MoE en FP4, un format que seuls les GPU Blackwell accélèrent nativement, et ne publie, côté vLLM, aucun run vision en dehors de GB200 (4x). La recette décrit toutefois une stratégie pour des nœuds 8-GPU H200/B200/B300, mais sans run vision vérifié sur ces machines ; son exécution sur H100 reste donc, au mieux, expérimentale et limitée en contexte.
Offres pour faire tourner MiniMax M2.5 ?
D'après mon analyse à l'aide de Sonnet 5 des pages recettes vLLM, des issues GitHub vLLM et d'autres articles trouvés plus largement sur Internet, je pense que MiniMax M2.5 peut tourner avec une context window de 192K de tokens sur les offres suivantes :
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | H100-SXM-4-80G | 12,77 € | 9 322 € |
| OVH | 4x H100 (80 Go HBM2) | 11,2 € | 7 770 € |
Tarifs si les serveurs sont loués seulement sur certaines plages horaires
En théorie, si les GPUs sont disponibles dans les stocks des providers, il est possible de les instancier et de les libérer à la demande.
Je pense que si les volumes des disques des VMs sont sauvegardés, une instance doit pouvoir se lancer en quelques minutes, sinon je pense qu'une instance doit pouvoir être provisionnée de zéro en quelques dizaines de minutes.
Je vais faire quelques estimations en fonction des hypothèses de disponibilité suivantes :
- 4 jours par semaine, de 14h à 18h (avec 30 min de démarrage) : 4h30 x 4 x 4 = 72h par mois
- 4 jours par semaine, de 9h à 18h (avec 30 min de démarrage) : 9h30 x 4 x 4 = 152h par mois
- 5 jours par semaine, de 9h à 18h (avec 30 min de démarrage) : 9h30 x 5 x 4 = 190h par mois
| Provider | Type de serveur | LLM | Prix à l'heure | 72h / mois | 152h / mois | 190h / mois |
|---|---|---|---|---|---|---|
| Scaleway | 4x H100 | MiniMax | 12,77 € | 919 € | 1 941 € | 2 426 € |
| OVH | 4x H100 | MiniMax | 11,2 € | 806 € | 1 702 € | 2 128 € |
| Scaleway | 8x B300 | DeepSeek | 60 € | 4 320 € | 9 120 € | 11 400 € |
| OVH | 4x H200 | DeepSeek | 23,12 € | 1 664 € | 3 514 € | 4 392 € |
| OVH | 8x H200 | DeepSeek | 42 € | 3 024 € | 6 384 € | 7 980 € |
Attention toutefois, il est nécessaire de passer par le support de Scaleway pour accéder aux instances B300 :
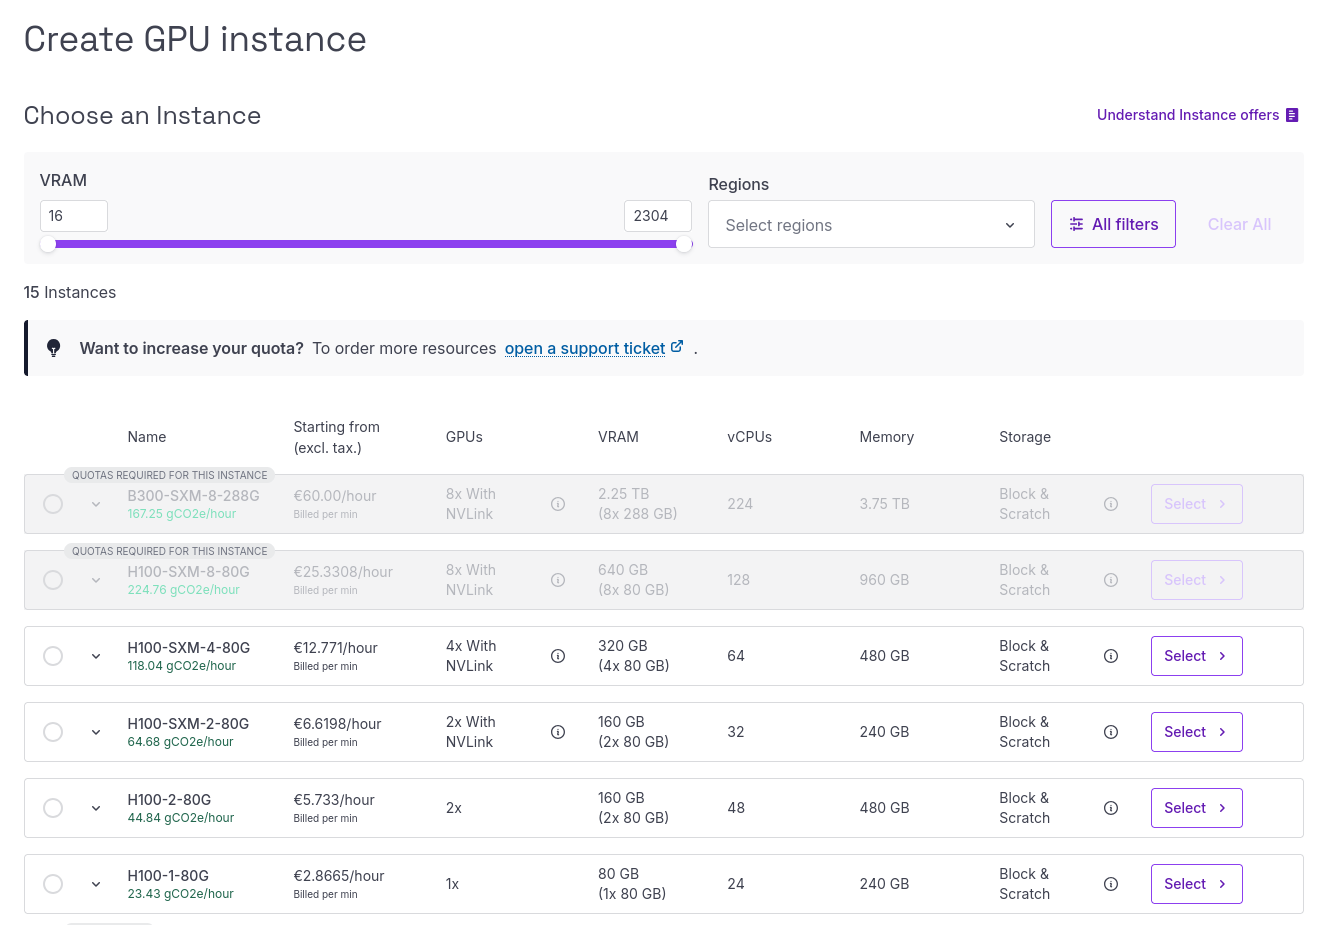
Peut-être qu'il n'est pas possible de louer ce type de machine avec une totale liberté, ce que je pourrais comprendre pour du matériel (8xB300) que Sonnet 5 estime à l'achat entre 300 K€ et 500 K€ pour un serveur complet de 8 GPU.
Estimation du nombre d'utilisateurs simultanés et du débit en tokens par seconde ?
vLLM et SGLang documentent des méthodes de calcul et de benchmark pour faire ce genre d'estimation, par exemple : Parallelism and Scaling, Benchmark CLI, vllm bench serve, Benchmark and Profiling, Bench Serving Guide. Mais je n'ai pas voulu me lancer en profondeur dans ce sujet, d'autant plus que j'ai l'impression que pour obtenir des informations concrètes il est nécessaire de lancer des outils sur l'environnement installé sur le serveur.
À la place, j'ai préféré prendre un raccourci et me baser sur les mesures que j'ai trouvées sur des pages du site Lambda : How to deploy DeepSeek-V4-Flash on Lambda et How to deploy MiniMax M2.5 on Lambda.
Je ne vais pas entrer dans les détails, mais voici les mesures pour DeepSeek-V4-Flash pour 32 utilisateurs en parallèle avec des prompts de 8192 tokens en entrée :
| Backend | Hardware | Par utilisateur | TTFT moyen | ITL moyen |
|---|---|---|---|---|
| SGLang | 8x B200 (FP4+FP8 natif) | 38 tok/s | 1 701 ms | 66 ms |
| SGLang | 8x H100 (FP8 quantifié) | 39 tok/s | 2 463 ms | 60 ms |
| vLLM | 8x B200 (FP4+FP8 natif) | 46 tok/s | 1 452 ms | 20 ms |
La même chose pour MiniMax M2.5, toujours pour 32 utilisateurs :
| Backend | Hardware | Par utilisateur | TTFT moyen | ITL moyen |
|---|---|---|---|---|
| SGLang | 2x B200 | 28 tok/s | 3 091 ms | 36 ms |
| SGLang | 4x H100 | 27 tok/s | 13 131 ms | 27 ms |
Voici comment je lis ces chiffres :
TTFT(Time To First Token) : délai avant le premier token affiché à l'écran.ITL(Inter-Token Latency) : écart entre deux tokens consécutifs pendant le decode.- Le débit par utilisateur (27 à 46 tok/s) dépasse la lecture humaine (5 à 10 tok/s), donc l'expérience est confortable. Cette vitesse vaut aussi pour les tokens de réflexion.
La config MiniMax 4xH100 est exactement celle que j'ai retenue chez Scaleway et OVH. Le benchmark s'applique donc directement, contrairement à DeepSeek où Lambda mesure du 8-GPU B200/H100 alors que je vise du 4x ou 8x H200.
Conclusion, en me basant sur ces mesures, je peux espérer qu'avec ces serveurs, l'expérience d'utilisation de ces modèles soit agréable pour 32 utilisateurs en simultané.
C'est un ordre de grandeur : avec DeepSeek, j'ai estimé qu'en réalité un nœud peut servir environ 200 utilisateurs actifs, puisque personne n'envoie de requêtes en continu.
Dernièrement, un ami m'a demandé : « qu'est-ce que je dois faire signer à mes clients pour être autorisé légalement à analyser leurs données confidentielles à l'aide d'un LLM, en fonction des types d'hébergement qui s'offrent à moi ? ».
Il travaille dans une entreprise sous-traitante industrielle. Contrairement à ma note du mois de juin, cette fois il ne s'agit pas de Données de santé (DDS), ni de PII, mais de secrets industriels. D'après ce que j'ai compris, le sujet est surtout contractuel.
Pour la suite de cette note, j'appelle Verdier Industries (nom fictif) l'entreprise de mon ami, afin d'incarner mes propos.
Dans cette note, je veux être très pratique : je souhaite générer des exemples de documents légaux à faire signer aux clients de Verdier Industries en fonction des options suivantes :
- a. LLM en SaaS hors UE
- b. LLM en SaaS en Europe hors France
- c. LLM en SaaS en France
- d. LLM installé sur une machine virtuelle avec GPU, louée chez Scaleway, OVH, etc.
- e. LLM installé sur un serveur physique dans ses locaux
Idéalement, je souhaite pouvoir facilement comparer ces documents légaux et analyser l'impact que cela aura sur la relation commerciale.
Lesquels risquent de faire peur à ses clients ou au contraire de les rassurer.
Avant d'entrer dans le détail, une précision sur le terme « accès à un LLM ». Si je simplifie, un LLM s'utilise de deux façons très différentes :
- via une interface de chat, dans un navigateur ou une application : c'est le cas de ChatGPT, Claude, Le Chat (Mistral AI), etc. Une personne écrit un message, le modèle répond. Ces noms désignent des interfaces de chat, pas le modèle qui est derrière. Les modèles portent d'autres noms.
- via une API : une sorte de porte d'entrée technique qui permet à un logiciel d'envoyer des demandes au modèle automatiquement, sans qu'un humain tape dans une fenêtre de chat. Quelques exemples de modèles connus au mois de septembre 2026 : GPT-5.6 Sol, Claude Sonnet 5, DeepSeek 4.1 Flash.
Dans cette note, je ne traite que du second cas, l'accès par API.
La raison : c'est le modèle LLM qui est très difficile à héberger soi-même, pas l'interface de chat.
Un LLM a besoin de serveurs puissants, équipés de GPU coûteux. Une fois qu'on dispose d'un accès au modèle, héberger une interface de chat comme Open WebUI ou LibreChat est plutôt facile, car ces services fonctionnent sur des machines modestes.
Autrement dit, les cinq options ci-dessous décrivent surtout où et comment on accède au modèle, pas comment on l'affiche à l'écran.
Une dernière précision : cette note traite uniquement des questions légales. Je compte publier une autre note pour tout ce qui concerne les estimations de coût d'hébergement pour chacune de ces options.
Je détaille les cinq options d'accès à un LLM
J'ai fait le choix de découper les offres commerciales réellement disponibles pour chacune de ces options par localisation du traitement des données, et non pas par juridiction du fournisseur.
J'ai indiqué la juridiction du fournisseur dans le tableau de synthèse en fin de section. Je tiens à préciser que cette question de juridiction n'est pas anecdotique pour les clients.
Solutions SaaS
Un service SaaS, ici, veut dire que le modèle est fourni et exécuté par un tiers : les données de Verdier Industries et de ses clients partent chez le fournisseur, qui renvoie une réponse. Contrairement aux solutions IaaS, Verdier Industries n'a donc pas besoin d'un administrateur système, interne ou externe, pour gérer le serveur qui fait tourner le modèle, ni pour s'occuper du modèle.
LLM en SaaS hors UE (a)
Lieu de traitement des données : hors de l'Union européenne.
Les offres les plus courantes en API directe chez des producteurs de LLM sont :
On trouve aussi des AI providers comme Deepinfra ou Together AI.
LLM en SaaS en Europe hors France (b)
Lieu de traitement des données : dans l'UE, mais le fournisseur n'est pas français.
Côté américain, l'endpoint européen d'OpenAI traite les données en Irlande (Dublin). Attention, le contrat reste conclu avec une entité américaine : OpenAI reste donc soumis au Cloud Act.
On y trouve aussi des acteurs européens comme :
- IONOS et leur offre AI Model Hub
- ou STACKIT et leur offre AI Model Serving
mais ces deux acteurs offrent un accès seulement à des modèles peu puissants.
LLM en SaaS en France (c)
Lieu de traitement des données : en France.
Les offres portées par une entité française sont :
- Mistral AI
- OVHcloud avec AI Endpoints
- Scaleway avec Generative APIs
En septembre 2026, Mistral AI et OVHcloud ne proposent que des modèles très peu puissants, bien loin derrière GLM-5.2 ou DeepSeek V4 Flash 0731 proposé par Scaleway.
Les acteurs américains peuvent aussi traiter dans des data centers en France, à condition de choisir explicitement un déploiement mono-région :
- AWS avec Bedrock
- Azure avec Azure OpenAI
- Google Cloud avec Vertex AI
- Together AI avec leur offre Dedicated inference, tuned for production
Pour tous ces acteurs, le contrat reste conclu avec une entité américaine : ils restent donc soumis au Cloud Act.
Solutions IaaS en France (d)
Une machine virtuelle avec GPU louée, c'est de l'IaaS : seule l'infrastructure est louée, le modèle LLM est installé et administré par un informaticien administrateur système de Verdier Industries. Le fournisseur n'a donc pas accès à l'OS de la machine virtuelle, donc pas aux données traitées.
Nuance : sur une machine virtuelle, l'hébergeur contrôle l'hyperviseur et pourrait en théorie accéder à la mémoire de la VM, ce qui n'est pas le cas sur un serveur bare metal.
- Quelques acteurs français :
- Scaleway, offres GPU Instances
- OVH, offres Cloud GPU
- Outscale, offres GPU NVIDIA
- Cloud Temple
- Acteurs américains dans leur datacenter en France soumis au Cloud Act :
- Together AI, offres GPU clusters
- AWS, offres Accelerated computing Amazon EC2 instance types
- Azure, offres GPU accelerated VM size series
- Google Cloud, offres accelerator-optimized
Sur site, un serveur dans les locaux de Verdier Industries (e)
Le serveur est dans les locaux de Verdier Industries : aucun tiers n'intervient, ni pour la machine, ni pour le modèle.
L'informaticien administrateur système de Verdier Industries doit prendre en charge l'installation, sur ce serveur, de logiciels comme vLLM, Ollama ou llama.cpp permettant d'instancier des LLM.
À ce coût matériel, DeepSeek V4 Flash me dit qu'il faut ajouter la facture d'électricité : un serveur 8x H100 ou H200 consomme de l'ordre de 10 kW au niveau informatique et 14 kW au niveau de l'installation, refroidissement inclus, soit de l'ordre de 15 000 à 30 000 € par an à pleine charge selon le prix du kWh.
Concrètement, un tel serveur ne peut pas être placé dans une pièce de bureaux : il faut une alimentation électrique dédiée, un refroidissement dimensionné et une pièce isolée acoustiquement.
Tableau de synthèse
| Option | Fournisseur | Pays de l'entité | Datacenter | Résidence UE | Exposition CLOUD Act |
|---|---|---|---|---|---|
| SaaS hors UE | OpenAI | États-Unis | États-Unis | Non | Oui |
| SaaS hors UE | Anthropic | États-Unis | États-Unis | Non | Oui |
| SaaS hors UE | États-Unis | États-Unis | Non | Oui | |
| SaaS hors UE | Deepinfra | États-Unis | États-Unis | Non | Oui |
| SaaS hors UE | Together AI | États-Unis | États-Unis | Non | Oui |
| SaaS Europe hors France | OpenAI | États-Unis | UE (Irlande) | Oui | Oui |
| SaaS Europe hors France | IONOS | Allemagne | UE | Oui | Non |
| SaaS Europe hors France | STACKIT | Allemagne | UE | Oui | Non |
| SaaS en France | Mistral AI | France | France | Oui | Non |
| SaaS en France | Scaleway | France | France | Oui | Non |
| SaaS en France | OVHcloud | France | France | Oui | Non |
| SaaS en France | AWS | États-Unis | France | Oui | Oui |
| SaaS en France | Microsoft | États-Unis | France | Oui | Oui |
| SaaS en France | États-Unis | France | Oui | Oui | |
| SaaS en France | Together AI | États-Unis | France | Oui | Oui |
| IaaS | Scaleway | France | France | Oui | Non |
| IaaS | OVHcloud | France | France | Oui | Non |
| IaaS | Outscale | France | France | Oui | Non |
| IaaS | Cloud Temple | France | France | Oui | Non |
| IaaS | Together AI | États-Unis | France | Oui | Oui |
| IaaS | AWS | États-Unis | France | Oui | Oui |
| IaaS | Microsoft | États-Unis | France | Oui | Oui |
| IaaS | États-Unis | France | Oui | Oui | |
| Sur site | — | Auto-hébergé | Locaux de Verdier Industries | Oui | Non |
Les 6 situations contractuelles
À partir de toutes les options d'hébergement d'un LLM listées précédemment, voici la liste de toutes les situations contractuelles.
Le classement va du plus simple à opérer (SaaS hors UE) au plus difficile (serveur sur site).
| Cas | Option | Exposition des données à un tiers | Transfert hors UE | Cloud Act |
|---|---|---|---|---|
| 1 | (a) SaaS hors UE | Oui | Oui | Oui |
| 2 | (b/c) SaaS datacenter en UE ou FR, entité US | oui | Non | Oui |
| 3 | (b/c) SaaS datacenter en UE ou FR, entité UE | oui | Non | Non |
| 4 | (d) IaaS US avec datacenter en FR | non | Non | Oui |
| 5 | (d) IaaS FR avec data center en FR | non | Non | Non |
| 6 | (e) sur site | aucun tiers | Non | Non |
Liste des démarches administratives à effectuer pour chaque situation contractuelle
Je pars de la situation suivante : Verdier Industries a déjà 50 clients sous contrat, il décide de réaliser les démarches légales auprès de ses clients afin d'être autorisé à envoyer des données confidentielles de ses clients à son LLM à travers la solution qu'il a retenue. Quels sont les documents à produire, envoyer au client, faire signer, etc.
Hypothèse générale : les contrats clients interdisent la divulgation des données confidentielles à un tiers sans accord écrit. Un avenant signé est donc nécessaire.
J'ai dressé la liste des étapes de ces procédures administratives avec l'aide de DeepSeek V4.1 Flash.
Cas 1 - SaaS hors UE
Procédure pas à pas :
- Verdier Industries demande à son fournisseur (par exemple OpenAI) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-entraînement et de rétention zéro ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- ses CCT (Clauses Contractuelles Types), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017, 27018, 27701 et 42001, SecNumCloud ou HDS.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation de divulgation des données à un tiers ;
- article 2 : confidentialité ;
- article 3 : acceptation du risque Cloud Act ;
- article 4, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD) et annexe des CCT.
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Selon ce que prévoit le contrat client pour le RGPD :
- Si le contrat contient une autorisation générale, par exemple : « Le client autorise Verdier Industries à recourir à des sous-traitants ultérieurs. Verdier Industries informe le client par écrit au moins 30 jours à l'avance, et le client peut s'opposer à cette modification. » Alors, pour le RGPD, Verdier envoie une simple notification, et si le client ne s'oppose pas dans les 30 jours, le nouveau sous-traitant est accepté, sans signature.
- Si le contrat contient une autorisation spécifique, par exemple : « Verdier Industries ne peut confier les données à un sous-traitant ultérieur qu'après accord écrit préalable du client. » Alors Verdier doit faire signer l'avenant pour le RGPD aussi.
- Dans les deux cas, ces clauses ne couvrent ni les secrets industriels ni le risque Cloud Act : pour ces deux points, l'avenant doit être signé.
Cas 2 - SaaS datacenter en UE ou FR, entité US
Les données sont traitées dans l'UE, mais le fournisseur est une entité américaine : il reste soumis au Cloud Act. Comme il n'y a pas de transfert hors UE, les CCT ne sont pas nécessaires.
Procédure pas à pas :
- Verdier Industries demande à son fournisseur (par exemple l'endpoint européen d'OpenAI) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-entraînement et de rétention zéro ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017, 27018, 27701 et 42001.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation de divulgation des données à un tiers ;
- article 2 : confidentialité ;
- article 3 : acceptation du risque Cloud Act ;
- article 4, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels et le risque Cloud Act imposent une signature.
Cas 3 - SaaS datacenter en UE ou FR, entité UE
Les données sont traitées dans l'UE par une entité européenne : ni transfert hors UE, ni exposition au Cloud Act.
Procédure pas à pas :
- Verdier Industries demande à son fournisseur (par exemple Scaleway) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-entraînement et de rétention zéro ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017, 27018, 27701 et 42001, SecNumCloud ou HDS.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation de divulgation des données à un tiers ;
- article 2 : confidentialité ;
- article 3, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels impose une signature.
Cas 4 - IaaS US avec datacenter en FR
L'infrastructure est louée chez un hébergeur américain. L'hébergeur n'accède pas au contenu des données, mais il reste soumis au Cloud Act.
Procédure pas à pas :
- Verdier Industries demande à son hébergeur (par exemple AWS) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-accès au contenu des données hébergées : mémoire vive, volumes de stockage et snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017 et 27018.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation d'héberger les données sur une infrastructure tierce ;
- article 2 : Verdier Industries garantit que l'hébergeur n'a pas accès au contenu des données, son accès étant limité à l'infrastructure nécessaire à l'hébergement, hors réquisition d'une autorité judiciaire ou administrative compétente ;
- article 3 : acceptation du risque Cloud Act ;
- article 4, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels et le risque Cloud Act imposent une signature.
L'engagement de non-accès demandé à l'hébergeur peut être rédigé ainsi :
L'hébergeur s'engage à ne pas accéder au contenu des données hébergées, en particulier à la mémoire vive, aux volumes de stockage et aux snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente. En cas de réquisition, l'hébergeur en informe Verdier Industries dans les meilleurs délais, sauf si la loi lui interdit de le faire.
Cas 5 - IaaS FR avec data center en FR
L'infrastructure est louée chez un hébergeur français ou européen : ni transfert hors UE, ni exposition au Cloud Act.
Procédure pas à pas :
- Verdier Industries demande à son hébergeur (par exemple Scaleway) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-accès au contenu des données hébergées : mémoire vive, volumes de stockage et snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017 et 27018, SecNumCloud ou HDS.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation d'héberger les données sur une infrastructure tierce ;
- article 2 : Verdier Industries garantit que l'hébergeur n'a pas accès au contenu des données, son accès étant limité à l'infrastructure nécessaire à l'hébergement, hors réquisition d'une autorité judiciaire ou administrative compétente ;
- article 3, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels impose une signature.
L'engagement de non-accès demandé à l'hébergeur peut être rédigé ainsi :
L'hébergeur s'engage à ne pas accéder au contenu des données hébergées, en particulier à la mémoire vive, aux volumes de stockage et aux snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente. En cas de réquisition, l'hébergeur en informe Verdier Industries dans les meilleurs délais, sauf si la loi lui interdit de le faire.
Cas 6 - Hébergement sur site
Le serveur est dans les locaux de Verdier Industries : aucun tiers n'intervient.
- Aucun document à obtenir d'un tiers.
- Aucun avenant à faire signer : les données ne quittent pas les locaux et ne sont divulguées à personne.
- Pour rassurer le client, Verdier Industries peut l'informer que le traitement se fait en interne, sans sous-traitant ultérieur.
Liste des différences entre les situations contractuelles
Différences entre cas 2 et cas 1
- Les données restent dans l'UE : les CCT ne sont plus nécessaires.
- Le reste est identique, notamment le risque Cloud Act.
Différences entre cas 3 et cas 2
- Le fournisseur est une entité européenne : plus de risque Cloud Act.
- L'article 3 de l'avenant (acceptation du risque Cloud Act) disparaît.
- Le reste est identique.
Différences entre cas 4 et cas 3
- Le fournisseur ne traite plus les données : l'hébergeur n'accède pas au contenu, et l'avenant le garantit (article 2).
- L'engagement de non-entraînement et de rétention zéro disparaît.
- L'article 1 de l'avenant devient une autorisation d'héberger, et non plus une autorisation de divulgation.
- Le risque Cloud Act réapparaît, car l'hébergeur est américain.
Différences entre cas 5 et cas 3
- Le fournisseur ne traite plus les données : l'hébergeur n'accède pas au contenu, et l'avenant le garantit (article 2).
- L'engagement de non-entraînement et de rétention zéro disparaît, remplacé par un engagement de non-accès au contenu.
- L'article 1 de l'avenant devient une autorisation d'héberger, et non plus une autorisation de divulgation.
- Les certifications attendues sont allégées : plus de 27701 ni 42001, qui n'ont plus de sens quand le fournisseur ne traite pas les données.
- Le reste est identique : ni transfert hors UE, ni risque Cloud Act.
Différences entre cas 5 et cas 4
- L'hébergeur est français ou européen : plus de risque Cloud Act.
- L'article 3 de l'avenant (acceptation du risque Cloud Act) disparaît.
- Le reste est identique.
Différences entre cas 6 et cas 5
- Aucun tiers n'intervient : plus de documents à obtenir ni d'avenant à signer.
- Il ne reste qu'une information au client, sans sous-traitant ultérieur.
Ce que je retiens
En travaillant cette note, je m'attendais, naïvement, à ce que le cas 5 — un LLM installé sur une machine virtuelle avec GPU louée chez un hébergeur français, dans un data center français — soit indolore contractuellement, c'est-à-dire qu'il n'exige aucun avenant aux contrats clients, mais ce n'est pas le cas.
En réalité, l'infrastructure reste louée à un tiers. Les contrats clients interdisent la divulgation des données confidentielles à un tiers sans accord écrit, et même si l'hébergeur n'accède pas au contenu, le fait de lui confier l'infrastructure qui porte les données déclenche quand même la signature.
Gagner en souveraineté réduit le nombre d'articles et la gravité du risque, mais ne ramène pas le travail contractuel à zéro.
Mon regard de praticien de terrain
Comme dans ma note du mois de juin sur les données de santé, je termine cette note avec un sentiment partagé.
Je suis un praticien de terrain : j'administre les serveurs, je gère les données de mes propres mains. En lisant tout cet édifice contractuel, je sais qu'il s'agit d'une convention humaine — ce que l'on nomme le constructivisme juridique, il me semble — souvent assez éloignée de la logique et de la pratique du terrain.
C'est un exercice d'analyse que j'aime beaucoup, mais qui m'est difficile. Il me crée une dissonance cognitive. D'un côté, je pense en praticien : je vois ce qu'on pourrait faire techniquement, concrètement, physiquement, pour renforcer la sécurité des données. De l'autre, ces protections juridiques sanctionnent devant un juge, mais ne protègent pas la donnée physiquement. C'est une protection par la sanction, pas une protection réelle. Ma culture hacker est de protéger pour de vrai, pas par le droit. Je crois que c'est là la source de ma dissonance, et parfois de mon énervement.
J'y trouve régulièrement de l'incohérence, parfois une forme d'hypocrisie, un peu comme un jeu de théâtre. Je ne dis pas que cela ne sert à rien — sans doute que ce cadre protège. Peut-être que mon regard de praticien me rend trop sensible à ce qui sépare la théorie juridique du terrain.
Ma cartographie de l'écosystème LLM de mars 2026
Dans cette hub note, j'essaie de cartographier les principaux concepts et composants de l'écosystème LLM, d'en clarifier les relations et d'affiner mon vocabulaire. Les dates et la dimension historique sont volontairement absentes — cette note décrit l'écosystème tel qu'il est en 2026, pas comment il en est arrivé là.
À la base, on trouve les laboratoires de recherche — OpenAI, Anthropic, Mistral AI, DeepSeek, Qwen Team, etc. — qui entraînent et publient les modèles. Ces modèles sont ensuite instanciés par des AI providers — Vertex AI (Google), Bedrock (AWS), Scaleway Generative APIs, chutes.ai, etc — qui les rendent accessibles via une API. La plupart des LLM producers jouent également ce rôle d'AI provider pour leurs propres modèles.
OpenRouter est également un AI provider, mais d'un type particulier : c'est un proxy qui s'intercale devant de nombreux AI providers pour offrir un point d'accès et une facturation unifiés.
Les AI providers instancient des Inference Engines — llama.cpp, vLLM, SGLang, ExLlamaV2, etc. — sur leurs serveurs, en y chargeant les poids d'un LLM.
Ces serveurs coûtent très cher, environ 30 000 € pour des H200, 40 000 € pour des B200, 50 000 € pour des B300. Les GPU de ces serveurs sont gravés par TSMC, tandis que la mémoire HBM est produite principalement par SK Hynix.
Si je simplifie, il existe deux familles de LLM, les modèles denses et les modèles Mixture of Experts (MoE). Ces derniers permettent un coût d'inférence réduit à paramètres totaux équivalents.
Généralement le grand public accède aux AI providers via leurs agents conversationnels web — ChatGPT, Claude, Le Chat, etc.
Les développeurs, eux, connectent leurs applications aux AI provider via une Web API : ces APIs respectaient initialement la convention OpenAI Chat Completions compatible API, mais les APIs ont progressivement divergé.
OpenAI cherche à imposer un standard commun avec Open Responses, tandis qu'Anthropic suit sa propre voie avec sa Messages API.
Beaucoup d'AI providers proposent deux modes de facturation : un abonnement donnant accès à leur agent conversationnel web, et un mode Pay-As-You-Go (à l'usage) donnant accès à leur Web API.
Le texte saisi par l'utilisateur dans un agent conversationnel web est transmis à l'API de l'AI provider au sein d'un prompt, qui contient également le System Prompt (LLM), l'historique de la conversation, et éventuellement du contexte additionnel. La taille maximale de l'ensemble prompt et réponse est nommée context window, exprimée en tokens.
Lorsque l'application enrichit ce prompt avec des données externes — issues d'une base de données vectorielle, d'une base de données relationnelle, d'un moteur de recherche full-text ou d'un moteur de recherche web — on nomme cette technique : RAG (Retrieval-Augmented Generation).
Pour écrire des données dans une base de données vectorielle, il est nécessaire de passer par une étape de vectorisation en utilisant un modèle d'embedding, comme par exemple Cohere Embed v3 multilingual, Voyage AI Text Embeddings ou text-embedding-3-large d'OpenAI. La vectorisation est également requise au moment d'effectuer la requête dans la base de données — avec impérativement le même modèle que celui utilisé lors de l'indexation.
Les modèles d'embedding sont nettement plus légers et économiques qu'un LLM. Ils peuvent être exécutés sur CPU pour des usages courants, sans nécessiter de GPU.
Depuis 2022, les RAG avancés suivent le pattern "Retrieve, rerank, Generate". L'étape de reranking peut être effectuée via deux méthodes :
- Des modèles spécialisés de reranking, comme Cohere Rerank, ou Voyage AI Rerankers, qui sont légers, rapides. Ils prennent en entrée la
queryet la liste de documents candidats et produisent un score de pertinence. - Ou directement des LLMs généralistes, potentiellement plus précis sur des domaines spécifiques non couverts par les données d'entraînement des modèles de reranking, mais plus coûteux en latence et en tokens.
Beaucoup de LLMs ont tendance à moins bien utiliser les informations situées au milieu d'un très long contexte — ce problème est nommé lost in the middle. Cela pénalise notamment les RAG, dont les chunks pertinents injectés en milieu de contexte risquent d'être sous-exploités par le modèle. Certains LLMs modernes comme Gemini 2.5 Pro ou GLM-5 ne sont plus victimes du lost in the middle sur de longs contextes. Jusqu'en 2025, répéter le prompt améliorait les résultats sur les modèles non-raisonnants. La question reste ouverte pour les LLMs de début 2026 : aucune étude publiée ne le confirme ni ne l'infirme à ce jour.
La technique d'activation de raisonnement chain-of-thought (CoT) par prompting sur les LLMs classiques est connue
depuis 2022.
Depuis o1 d'OpenAI en septembre 2024, les modèles sont entraînés spécifiquement pour le raisonnement via RL, on parle de Reasoning Language Model (RLM). L'utilisateur peut contrôler le niveau d'effort de raisonnement via le paramètre effort.
Les modèles Claude Sonnet et Opus 4.x adaptent dynamiquement l'effort de raisonnement en fonction de la complexité de la tâche — Anthropic nomme cela hybrid reasoning.
De nombreux AI provider permettent de configurer des tools qui permettent au modèle d'appeler des fonctions externes. Un tool est décrit sous la forme d'une structure JSON, constituée des champs name, description, input_schema. En fonction du contenu des messages, le LLM peut prendre la décision de demander l'exécution d'un ou plusieurs tools. Cette demande se matérialise dans le JSON de sa réponse (voir exemple).
Il existe deux types de tools :
- des built-in tools, fournis et exécutés par le AI provider — Web search, Web fetch, Code execution, Memory, etc.
- des custom tools, définis par le développeur via le Function calling, dont l'exécution est prise en charge par l'application.
La facturation des built-in tools est généralement incluse dans les abonnements des AI providers. Par contre, elles sont généralement facturées individuellement dans l'offre Pay-As-You-Go.
La majorité des AI providers supportent le standard Structured Outputs d'OpenAI pour garantir une réponse conforme à un JSON Schema précis.
Anthropic, quant à lui, ne supporte pas ce standard mais permet tout de même la génération de réponses structurées en JSON en passant par un tool.
Une application est qualifiée d'AI agent lorsqu'un LLM y prend de façon autonome des décisions en boucle pour atteindre un objectif — en appelant des tools, en consultant des sources via RAG, ou en déléguant à des sous-agents. La boucle s'arrête lorsque l'objectif est atteint ou qu'une intervention humaine est requise. En poussant l'idée, on peut dire qu'un assistant IA conversationnel basique, sans tools ni boucle, est la forme la plus minimaliste d'un AI agent. Les assistants conversationnels modernes comme ChatGPT ou Claude sont quant à eux devenus de véritables agents à part entière.
Les Inference Engines sont par nature stateless — chaque requête est traitée de façon indépendante, sans mémoire des échanges précédents. Certains AI providers proposent néanmoins du prompt caching : lorsqu'une portion du prompt est identique d'une requête à l'autre — même ordre, même contenu, token pour token — elle est mise en cache pour une courte durée, ce qui réduit à la fois la latence et le coût. C'est particulièrement utile pour les AI coding agents, dont les longues boucles agentiques répètent à chaque étape le même system prompt et le même historique de conversation.
Ce système de prompt caching peut être utile aussi pour une application métier qui envoie de nombreuses requêtes différentes partageant toutes le même long system prompt. Plutôt que de retraiter ces tokens à chaque fois, le provider les garde en cache côté serveur. En fonction du contexte d'utilisation de l'application, il est possible de choisir plusieurs durées de cache, par exemple Anthropic propose 5min ou 1h.
À noter que le prompt caching n'est pas un cache logiciel classique au sens applicatif : c'est une optimisation transparente et implicite côté inférence, sans gestion de clés ni invalidation manuelle.
La plupart des AI providers proposent une API asynchrone de type "batch" — exemples : POST /v1/messages/batches pour Anthropic, POST /batches pour OpenAI, ou POST /v1/batch/jobs pour Mistral AI.
Ces APIs sont conçues pour des tâches non temps-réel, avec un délai de traitement pouvant aller jusqu'à 24h, en échange d'une réduction de 50% sur le tarif standard.
Elles disposent par ailleurs de rate limits séparés des quotas synchrones, ce qui permet de soumettre de gros volumes sans impacter les appels temps-réel.
Le protocole MCP standardise la définition, la découverte et l'exécution de tools exposés par des serveurs externes.
Cela permet de connecter un AI agent à des centaines de serveurs MCP sans avoir à écrire la moindre ligne de code.
Cela permet aussi à n'importe quel développeur de publier un serveur MCP pour rendre son service accessible aux AI agents.
La logique est proche des API REST, à la différence que les interfaces MCP sont conçues pour être utilisées par des AI agents plutôt que par des développeurs.
Les AI agents devenant de plus en plus complexes à orchestrer, les développeurs s'appuient sur des frameworks agentiques — Vercel AI SDK, LangGraph, VoltAgent, etc. — pour gérer les boucles, la mémoire, les tools et l'observabilité.
Les développeurs utilisent des AI coding agents dans des agentic coding tools comme Claude Code, OpenCode, etc. Ces agents utilisent massivement les tools et chargent du contexte projet depuis des fichiers AGENTS.md — un standard collaboratif initié par Sourcegraph, OpenAI et Google.
Les AI coding agents peuvent également charger dynamiquement des « compétences » depuis des fichiers SKILL.md, un format introduit par Anthropic.
Lorsqu'il utilise un agentic coding tool comme Claude Code ou OpenCode, le développeur peut choisir quel type d'AI coding agent utiliser selon la nature de la tâche — certains moins coûteux pour les tâches simples, d'autres plus capables pour les tâches complexes. Par exemple pour OpenCode on trouve : agent build, agent plan, agent general, agent explore. Chez Claude Code : agent explore, agent plan, agent general-purpose. Ces agents peuvent également travailler en essaim : un agent orchestrateur décompose le travail et délègue des sous-tâches à plusieurs sous-agents exécutés en parallèle.
Certains agents conversationnels web, comme ChatGPT, Claude, etc., proposent des fonctionnalités de "memory layers" basées sur des tools spécifiques. Ces implémentations restent à ce jour plus opaques et moins puissantes que les services dédiés comme mem0, Graphiti, Letta, etc.
Les services de couche mémoire persistante utilisent généralement une architecture hybride combinant une base de données vectorielle et une base de données de graphe : la base vectorielle stocke des informations sémantiques probabilistes et le graphe stocke des informations symboliques. Ces deux types de données permettent de fournir à un agent IA un meilleur contexte.
Les développeurs peuvent tester leurs prompts et leurs AI agents avec des outils d'évaluation, comme Promptfoo, trulens, etc. Ces outils sont nommés LLM Evals. Cela ressemble un peu à des tests unitaires, mais à la différence de ces derniers, qui sont déterministes, les LLM Evals évaluent la qualité des réponses des LLMs de manière probabiliste, généralement en utilisant un LLM-as-a-Judge.
Des laboratoires de recherche en AI privés — OpenAI avec SimpleQA et PaperBench, Google DeepMind avec IFEval et FACTS Grounding, etc. — ou académiques (UC Berkeley avec Chatbot Arena, Princeton avec SWE-bench, Center for AI Safety avec GPQA et HLE) et des communautés (EleutherAI avec le LM Evaluation Harness, Hugging Face avec l'Open LLM Leaderboard) mettent au point des benchmarks pour publier des leaderboards publics. Les créateurs de LLM disposent également de benchmarks internes privés, dont les méthodologies et résultats ne sont pas communiqués de manière transparente.
2026-03-12 : des petites erreurs ont été corrigées et j'ai ajouté 7 paragraphes (détail des changements).